אם ב-Search Console מופיעים עמודים בסטטוס Blocked by robots.txt, או שהאתר נעלם מגוגל אחרי העברה או עדכון, הדבר הראשון שכדאי לבדוק הוא קובץ robots.txt. זה קובץ טקסט קטן בשורש האתר, שאומר לסורקים לאילו כתובות מותר להם להיכנס. מספיקה בו שורה אחת לא נכונה כדי שהסורק של גוגל (Googlebot) יפסיק לסרוק את כל האתר.
התיקון עצמו בדרך כלל פשוט: מוצאים את השורה שחוסמת, מוחקים או משנים אותה, ומבקשים מגוגל לקרוא את הקובץ מחדש. מה שלוקח זמן הוא להבין מאיפה הקובץ מגיע בכלל, כי בוורדפרס הוא יכול להיווצר מכמה מקומות שונים. ריכזתי כאן את הבדיקות לפי הסדר שבו כדאי לעבור עליהן.
קודם כל: מה robots.txt עושה ומה לא
לפי התיעוד של גוגל, הקובץ אומר לסורקים לאילו כתובות באתר מותר להם לגשת. הוא לא נועד להוציא עמוד מגוגל. עמוד שחסום בקובץ עדיין יכול להופיע בתוצאות אם אתרים אחרים מקשרים אליו, ולפעמים הוא מופיע בלי תיאור. כדי שעמוד לא ייכנס לאינדקס צריך להשתמש ב-noindex או להגן עליו בסיסמה.
ההבדל הזה עובד לשני הכיוונים. חסימה בטעות בקובץ עוצרת את הסריקה, ולכן גוגל לא רואה את העדכונים שעשית בעמודים. ומהצד השני, אם חסמת עמוד בקובץ וגם שמת עליו noindex, גוגל לא יראה את ה-noindex, כי הוא בכלל לא סורק את העמוד. זו אחת הסיבות לסטטוס Indexed, though blocked by robots.txt, שגוגל מתאר כעמוד שנכנס לאינדקס בזכות קישורים אליו, למרות שלא נסרק.
בדיקה 1: מה כתוב בקובץ robots.txt עכשיו
הבדיקה הראשונה היא פשוט לפתוח בדפדפן את הכתובת https://הדומיין-שלך/robots.txt. גוגל קורא את הקובץ רק מהתיקייה העליונה של האתר, והכללים שבו חלים רק על אותו מארח, אותו פרוטוקול ואותה פורט. לכן לגרסה עם www ולגרסה בלי www יש כל אחת קובץ משלה, וכך גם ל-http ול-https.
בתוכן הקובץ כדאי לחפש שלושה דברים:
Disallow: /תחתUser-agent: *או תחתUser-agent: Googlebot. זו חסימה של כל האתר.- חסימות רחבות מדי, למשל
Disallow: /blogשחוסם גם את/blog-news/, כי הכלל תופס כל כתובת שמתחילה במחרוזת הזו. - הבדלים בין אותיות גדולות לקטנות. לפי גוגל הנתיב רגיש לאותיות, ולכן
/Shop/ו-/shop/הם שני כללים שונים.
כשיש כללים סותרים, גוגל בוחר את הכלל הספציפי ביותר לפי אורך הנתיב, ואם יש תיקו, את הכלל שמתיר יותר. בגלל זה Allow ארוך יכול לגבור על Disallow קצר.
כך נראה robots.txt תקין ובסיסי לאתר וורדפרס רגיל, בדומה למה שוורדפרס מייצר בעצמו:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/wp-sitemap.xml
בדיקה 2: דוח robots.txt ב-Search Console
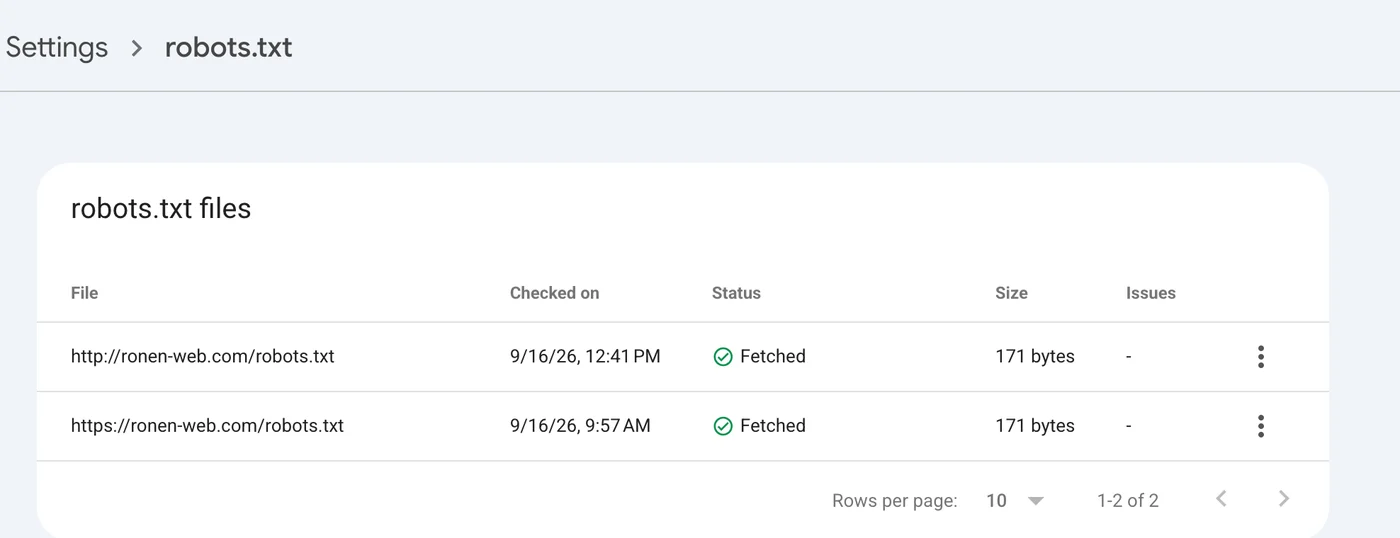
ב-Search Console נכנסים ל-Settings ופותחים את הדוח robots.txt. הדוח מראה אילו קבצים גוגל מצא ב-20 המארחים המובילים של האתר, מתי ניסה לקרוא אותם בפעם האחרונה, ואילו אזהרות או שגיאות מצא בהם. הדוח זמין רק לנכס ברמת הדומיין: נכס מסוג Domain, או נכס מסוג URL prefix בלי נתיב.
בעמודה Fetch status יופיע אחד מכמה מצבים. Fetched אומר שגוגל קרא את הקובץ, ואז כדאי לפתוח אותו ולראות בדיוק איזו גרסה נמצאת אצל גוגל. Not Fetched - Not found (404) אומר שאין קובץ, וזו לא בעיה: לפי גוגל, שגיאות 4xx (חוץ מ-429) מתפרשות כאילו אין קובץ בכלל, ולכן אין שום הגבלה על הסריקה.
המקרה שכן מסוכן הוא שגיאת שרת 5xx בכתובת של הקובץ. במצב כזה גוגל מפסיק לסרוק את האתר וממשיך לנסות לקרוא את הקובץ במשך 12 שעות. אחרי זה הוא משתמש בגרסה האחרונה ששמר, עד 30 יום. אם הקובץ מחזיר שגיאת שרת, הבעיה היא בשרת שמגיש אותו ולא בכללים שכתובים בו.
בדיקה 3: ההגדרה "Discourage search engines" בוורדפרס
בלוח הבקרה של וורדפרס נכנסים ל-Settings ואז ל-Reading, ומסתכלים על התיבה Discourage search engines from indexing this site. את התיבה הזו מסמנים כשהאתר בבנייה, והרבה פעמים שוכחים לבטל אותה כשהאתר עולה לאוויר.
מה שהיא עושה השתנה עם השנים. עד גרסה 5.2 היא גרמה לקובץ להחזיר Disallow: /. מגרסה 5.3 היא מוסיפה במקום זה תגית noindex, nofollow לראש כל עמוד, והקובץ הווירטואלי כבר לא חוסם הכול. לכן אם התיבה מסומנת, מה שתראה ב-Search Console יהיה בדרך כלל noindex ולא חסימה בקובץ robots, אבל התוצאה דומה: האתר לא נכנס לגוגל. מבטלים את הסימון ולוחצים Save Changes.
בדיקה 4: קובץ פיזי מול קובץ וירטואלי
וורדפרס לא שומר את קובץ robots בדיסק. הוא מייצר אותו מחדש בכל בקשה, ולכן קוראים לו קובץ וירטואלי. מגרסה 5.5, כשהאתר ציבורי, וורדפרס גם מוסיף לו שורת Sitemap שמפנה למפת האתר המובנית. תוספי SEO כמו Rank Math עורכים את הקובץ הווירטואלי הזה. Yoast SEO עובד אחרת: עורך הקבצים שלו כותב קובץ פיזי.
הבעיה מתחילה כשיש גם קובץ robots.txt אמיתי בתיקייה הראשית של האתר, ליד wp-config.php. השרת מגיש את הקובץ הפיזי, ושום שינוי שתעשה בתוסף שעורך את הקובץ הווירטואלי, כמו Rank Math, לא ישפיע. זה קורה הרבה אחרי העברה מסביבת בדיקות, כשקובץ שנועד לחסום את סביבת הפיתוח עובר יחד עם שאר הקבצים.
כדי לבדוק את זה נכנסים עם FTP או עם מנהל הקבצים של האחסון לתיקייה הראשית, ומחפשים קובץ בשם robots.txt. אם הוא קיים והתוכן שלו זהה למה שראית בדפדפן, זה המקור. אפשר לערוך אותו ישירות, או למחוק אותו ולנהל את הקובץ מהתוסף. גם Rank Math כותבים בתיעוד שלהם שקובץ פיזי בשורש הוא הסיבה הנפוצה לכך שאי אפשר לערוך את הקובץ דרך התוסף.
בדיקה 5: הכללים שהתוסף מוסיף
אם אין קובץ פיזי, התוכן מגיע מוורדפרס ומהתוספים. אלה שני המקומות העיקריים:
- Yoast SEO: בתפריט Yoast SEO, תחת Tools, בוחרים File editor. העורך הזה עובד על קובץ פיזי, ואם אין כזה הוא מציע ליצור אותו. אם הקישור לא מופיע, ייתכן שעריכת קבצים חסומה בוורדפרס, ואז עורכים דרך FTP.
- Rank Math: Rank Math SEO, אחר כך General Settings ואז Edit robots.txt. האפשרות מופיעה רק כשהתוסף במצב Advanced Mode.
כדאי לעבור על כל שורת Disallow ולשאול אם היא באמת צריכה להיות שם, ובמיוחד על חסימות של תיקיות קבצים כמו /wp-content/ או /wp-includes/. גוגל כותב בתיעוד שלו שחסימה של משאבים כמו CSS ו-JavaScript מתאימה רק כשהעמוד לא מושפע משמעותית בלעדיהם, ובאתר וורדפרס הם בדרך כלל חלק מהאופן שבו העמוד נבנה.
בדיקה 6: Cloudflare והאחסון
אם האתר עובר דרך Cloudflare, כדאי לבדוק אם הופעלה שם ההגדרה המנוהלת של קובץ robots. לפי Cloudflare, כשההגדרה פעילה היא מוסיפה בתחילת הקובץ שלך כללים שחוסמים סורקים של בינה מלאכותית כמו GPTBot ו-Google-Extended, ואחריהם מגיע התוכן המקורי. היא לא חוסמת את Googlebot הרגיל, כך שהיא לא אמורה להוציא אותך מגוגל. אבל אם אתה רואה בקובץ שורות שלא כתבת, כאן כדאי לחפש. ואם אתה דווקא רוצה לתת לבוטים האלה גישה כדי להופיע במנועי תשובה, יש לזה קובץ נפרד, וכתבתי עליו במדריך קובץ llms.txt. על הנושא הרחב יותר, הנראות במנועי בינה מלאכותית, כתבתי מדריך נפרד על קידום GEO.
באותה הזדמנות כדאי לוודא שהכתובת של הקובץ לא מחזירה שגיאת שרת, ושחומת האש לא חוסמת בה את הסורקים. כמו שראינו בבדיקה 2, שגיאת 5xx בקובץ עוצרת את הסריקה של כל האתר, גם כשהתוכן של הקובץ תקין.
אחרי התיקון: איך מעדכנים את גוגל
לפי גוגל, הסורקים מעדכנים את הגרסה השמורה של הקובץ בדרך כלל פעם ב-24 שעות. כדי לזרז את זה, חוזרים לאותו דוח ב-Search Console, פותחים את התפריט שליד הקובץ ובוחרים Request a recrawl. גוגל מגדיר את האפשרות הזו למצבי חירום, וחסימה של כל האתר היא בדיוק מצב כזה.
אחר כך יש עוד שתי בדיקות:
- בכלי URL Inspection בודקים עמוד חשוב. השדה Crawl allowed? מראה אם הקובץ מתיר לגוגל לסרוק אותו, ו-Test live URL בודק את המצב כפי שהוא עכשיו.
- בדוח Pages פותחים את הסיבה Blocked by robots.txt ולוחצים Validate fix. לפי גוגל, האימות לוקח בדרך כלל עד שבועיים, ולפעמים יותר.
אם האתר חזר להיסרק ועדיין לא מופיע, הבעיה כבר לא בקובץ robots. ייתכן שהעמודים נמצאים בסטטוס Crawled currently not indexed, ועל הבדיקות שמתאימות למצב הזה כתבתי מדריך נפרד. על שאר הסיבות כתבתי במאמר למה האתר שלי לא מופיע בגוגל.
מתי לעצור לפני שמוחקים שורה בקובץ
רוב המקרים נפתרים בבדיקות שלמעלה. כדאי לעצור ולהביא מישהו כשאחד מאלה קורה:
- הקובץ מחזיר שגיאת שרת, או שהוא נראה אחרת בדפדפן ובדוח של Search Console, ואתה לא מוצא מאיפה מגיעה הגרסה שגוגל רואה.
- שינית את הקובץ, ביקשת סריקה מחדש, ואחרי כמה ימים הדוח עדיין מציג את הגרסה הישנה.
- באתר יש כמה תת-דומיינים, שפות או חנות, וכל שינוי בכללים עלול לפתוח לסריקה אזורים שלא אמורים להיות בגוגל, כמו עגלה, חשבון לקוח או תוצאות חיפוש פנימי.
- אתה לא בטוח מה כלל מסוים עושה. מחיקה של שורה בלי להבין אותה יכולה לפתוח לסריקה הרבה כתובות שלא אמורות להיסרק.
אם עברת על הכול והאתר עדיין חסום, אני יכול לטפל בזה. השאר פרטים כאן ונבדוק יחד מה חוסם את גוגל.
למי שרוצה לקרוא בתיעוד הרשמי: המבוא של גוגל לקובץ robots וההסבר על הדוח ב-Search Console.
שאלות נפוצות
האם robots.txt מונע מעמוד להופיע בגוגל?
לא. לפי גוגל, עמוד שחסום בקובץ עדיין יכול להיכנס לאינדקס אם יש אליו קישורים. כדי להוציא עמוד מהתוצאות משתמשים ב-noindex או בהגנת סיסמה, והעמוד צריך להיות פתוח לסריקה כדי שגוגל יראה את ה-noindex.
איפה נמצא קובץ robots.txt בוורדפרס?
ברוב האתרים אין קובץ פיזי. וורדפרס מייצר קובץ וירטואלי שמוגש בשורש הדומיין, ותוספים כמו Rank Math עורכים אותו. אם העלית קובץ אמיתי לתיקייה הראשית, השרת מגיש אותו במקום הווירטואלי.
כמה זמן לוקח לגוגל לראות שינוי ב-robots.txt?
לפי גוגל, הגרסה השמורה מתעדכנת בדרך כלל כל 24 שעות. אפשר לזרז דרך Request a recrawl בדוח robots.txt ב-Search Console.
מה קורה אם אין לאתר קובץ robots.txt בכלל?
גוגל מתייחס לשגיאת 404 בכתובת של הקובץ כאילו אין הגבלות, וסורק את האתר כרגיל. זה לא גורם לחסימת גוגל בטעות.
סימנתי Discourage search engines, האם זה משנה את קובץ robots?
מגרסה 5.3 של וורדפרס לא. ההגדרה מוסיפה תגית noindex לעמודים במקום לחסום בקובץ. התוצאה עדיין שהאתר לא ייכנס לגוגל, ולכן חשוב לבטל אותה כשהאתר עולה לאוויר.
האם לחסום את wp-admin?
וורדפרס עושה את זה כברירת מחדל: הוא חוסם את /wp-admin/ ומתיר את admin-ajax.php, שחלק מהתוספים צריכים. בדרך כלל אין סיבה לשנות את זה.